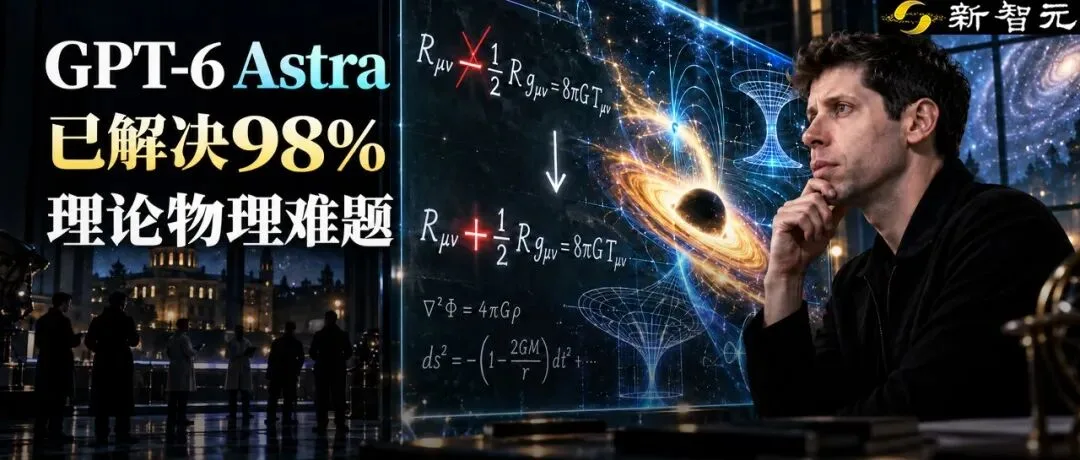
新智元报道 太震撼了。 就在刚刚,一项研究显示, GPT-6 Astra 已经解决了 98% 的全新理论物理难题 ! 这项顶级理论物理学评测 TheoPhysEval ,刚刚引发了学术界震动。 这些未发表的前沿难题,顶尖专家要花一整天才能解开。 但GPT-6 Astra不仅拿下近乎满分,甚至揪出了出题专家的计算失误! 人类专家低头认错后,GPT-6 Astr
新智元报道 ChatGPT也学会「摇人」组队干活了! 10月16日,OpenAI宣布升级ChatGPT中的GPT-6 Astra Pro: 回复更快,插件和工具使用能力增强,还能让多个智能体分头处理同一项任务。 一项复杂工作交出去,几个AI可以各管一块,同时推进。 你还能在对话里跟踪各自进度,单独点开已完成的任务,检查成果。 分头执行、跟踪进度、查看成果,这
新智元报道 如今的大模型,想要追求性能,往往要烧掉海量经费。Claude Opus或GPT等前沿模型,好用是真好用,贵也是真贵。 但如果现在告诉你: 有一套方案,不仅能在九项包含科学推理、业务自动化、工具调用、Agent能力等基准测试中力压群雄拿下第一,而且每次调用的平均成本只要区区0.06元,甚至不到对手的2% ,你会不会觉得不可思议? 就在近日,这件打破
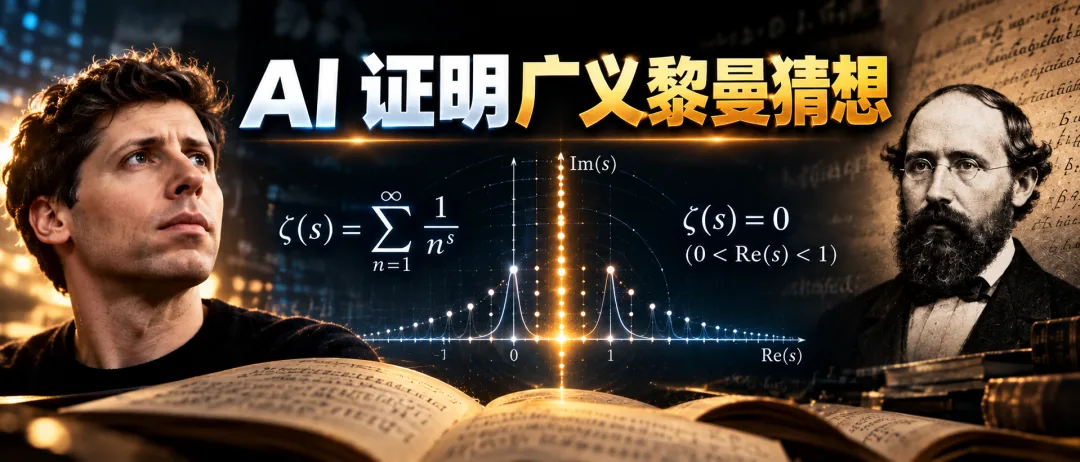
新智元报道 不到十天,数学界经历了一场终极过山车! 10月6日,OpenAI宣称AI证明了准黎曼假设。 数学家 Alex Kontororvin直言: 如果有人觉得了这一成果,那他肯定能立刻获得菲尔茨奖,毫无悬念 ! 他后续补充无 Siegel 零点或可算「两个菲尔兹奖」。 其他学者也有积极评价。 这简直是硅基生命对人类的降维打击! 但有人没有投降,没有退场
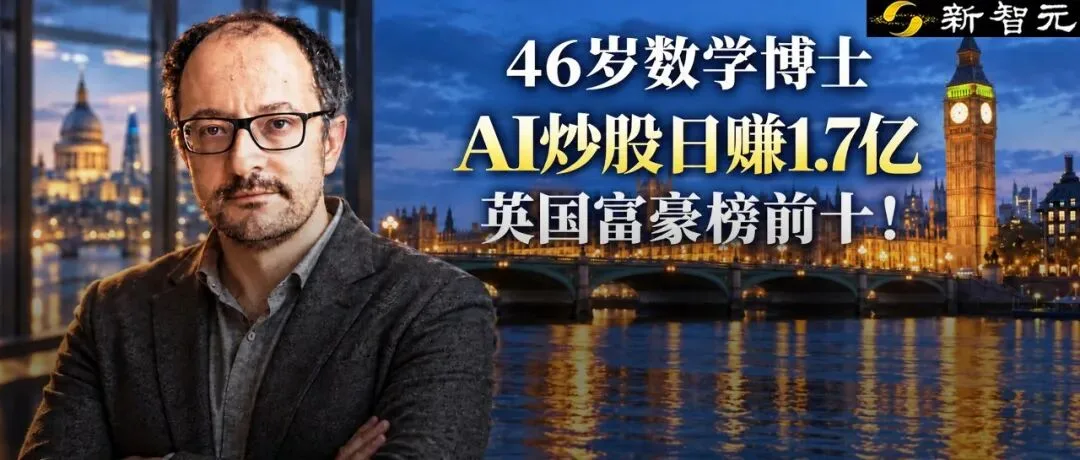
新智元报道 刚刚,用AI最会赚钱的英国人出现了! 据《星期日泰晤士报》最新发布的2026英国富豪榜,46岁的莫斯科国立大学数学博士Alex Gerko,以160.06亿英镑(约1417亿元人民币)的惊人身家,强势杀入英国富豪榜前十,位列第八! 过去短短一年,他的财富暴增了643亿元人民币——相当于平均每天睁开眼,就有近1.76亿元人民币自动划入他的账户。 他
脚本语言又被称为扩建的语言,或者动态语言,是一种编程语言,用来控制软件应用程序,脚本通常以文本(如ASCII)保存,只在被调用时进行解释或编译。
Docker 是一个开源的应用容器引擎,让开发者可以打包他们的应用以及依赖包到一个可移植的镜像中,然后发布到任何流行的 Linux或Windows操作系统的机器上,也可以实现虚拟化。容器是完全使用沙箱机制,相互之间不会有任何接口。
Docker 是一个开源项目,诞生于 2013 年初,最初是 dotCloud 公司内部的一个业余项目。它基于 Google 公司推出的` Go `语言实现。项目后来加入了 Linux 基金会,遵从了 Apache 2.0 协议,项目代码在[GitHub](https://github.com/docker/docker) 上进行维护
引言:
参数初始化是训练深度神经网络的一个关键步骤,目的是给网络中权重(weights)和偏置(biases)赋予初始值。合适的参数初始化方法有助于提高训练速度、避免梯度消失/爆炸问题,并且加速网络的收敛。
避免梯度消失和梯度爆炸:在深度神经网络中,参数初始化对梯度流动非常重要。如果初始权重值太大或太小,可能导致梯度爆炸或梯度消失,从而增加网络的训练难度。加速收敛:良好的初始化可以帮助网络在训练过程中更快地收敛,减少训练时间。打破对称性:在神经网络中,如果所有的神经元参数都初始化为相同的值,那么在训练过程中,它们会在每一层的计算中产生相同的输出,导致神经元学习到相同的特征。因此,初始化时需要打破对称性,给每个神经元不同的初始值。概念:由Xavier Glorot 提出的初始化方法,适用于 Sigmoid 和 Tanh 等激活函数。权重初始化时从均匀分布或正态分布中抽取,值的范围与输入和输出的维度相关。
公式(均匀分布):
其中 和 分别是当前层和下一层的神经元个数。
特点:适用于 Sigmoid 和 Tanh 激活函数。通过调节初始化的方差,使得信号在网络中保持稳定,避免了梯度爆炸和梯度消失。
使用场景:对于使用 Sigmoid 或 Tanh 激活函数的神经网络层(特别是全连接层),是一个常用的初始化方法。
概念:由 Kaiming He 提出的初始化方法,特别适用于 ReLU 激活函数及其变种(如 Leaky ReLU)。
公式(正态分布):
其中 是当前层的神经元个数。
特点:适用于 ReLU 和其他 ReLU 类似的激活函数。相比于 Xavier 初始化,He 初始化增加了一个因子 2,确保 ReLU 在正数区域时有更大的方差,避免梯度消失。
使用场景:对于 ReLU 激活函数及其变种(如 Leaky ReLU)常用的初始化方法。
概念:LeCun 初始化特别适用于 Sigmoid 和 Tanh 激活函数,尤其是在卷积神经网络(CNN)中应用广泛。
公式(正态分布):
其中 是当前层的神经元个数。
特点:适用于 Sigmoid 和 Tanh 激活函数。适用于卷积神经网络,特别是在处理小型图像数据时。
使用场景:适用于卷积层的初始化,特别是用于 Tanh 和 Sigmoid 激活函数的情况。
概念:Orthogonal 初始化方法初始化权重矩阵为一个正交矩阵。这种方法在每一层之间保持信号的稳定传播,尤其在深度神经网络中效果显著。
特点:适用于深度神经网络的权重初始化。通过使用正交矩阵保持不同层之间的梯度传播稳定,避免梯度消失。
使用场景:适用于深度网络,特别是使用 ReLU 或其他激活函数的网络层。
| 初始化方法 | 适用激活函数 | 特征 | 使用场景 |
|---|---|---|---|
| 零初始化 | 不适用 | 所有权重初始化为0 | 主要用于偏置初始化,避免用作权重初始化 |
| 随机初始化 | 所有激活函数 | 随机选择权重,打破对称性 | 简单网络结构,但可能导致梯度爆炸/消失问题 |
| Xavier 初始化 | Sigmoid, Tanh | 根据输入输出神经元数调整权重方差 | 适用于深度网络,特别是使用 Sigmoid 或 Tanh 激活函数 |
| He 初始化 | ReLU, Leaky ReLU | 更大的方差,适用于 ReLU 等激活函数 | 适用于使用 ReLU 或其变种的深度神经网络 |
| LeCun 初始化 | Sigmoid, Tanh | 小的方差,适用于卷积神经网络 | 适用于卷积神经网络,特别是 Sigmoid 和 Tanh 激活函数 |
| Orthogonal 初始化 | 所有激活函数 | 初始化为正交矩阵,保持信号稳定传播 | 深度神经网络,特别是 ReLU 或其变种的网络 |